

Jev AI : le modèle qui décide au lieu d'écrire, et Laya, son alternative open source

Jev est un modèle d'IA lancé le 15 septembre 2026 par TypeSafe AI. Il n'écrit pas : il choisit parmi des options que vous définissez et renvoie une probabilité pour chacune, en moins d'une seconde, pour environ 4 centimes d'euro par million de tokens. Il n'est pas open source ; Laya, publié sous licence Apache 2.0, reprend le principe et s'installe sur vos serveurs.
En bref : Jev et Laya en trente secondes
Jev est un modèle d’IA de la start-up californienne TypeSafe AI, lancé le 15 septembre 2026. Il ne rédige rien. Vous lui donnez une donnée, par exemple un e-mail, et des questions fermées : « quel service doit traiter ce message ? », « est-ce urgent ? ». Il renvoie une probabilité pour chaque réponse possible.
Cette spécialisation le rend très rapide et très bon marché. TypeSafe annonce des réponses en 70 à 500 millisecondes et un tarif d’environ 4 centimes d’euro par million de tokens (0,042 dollar), sortie gratuite.
- Ce que Jev fait bien : trier, classer, noter, vérifier. Des décisions répétitives, à grand volume, que votre code peut exploiter directement.
- Ce qu’il ne fait pas : écrire, résumer, converser. Ce n’est pas un concurrent de ChatGPT, c’est un autre outil.
- Ce qu’il n’est pas : open source. On y accède par une API hébergée aux États-Unis.
Laya, publié trois jours plus tard par Convai Innovations sous licence Apache 2.0, reprend la même idée. Vous téléchargez les poids, vous l’installez sur votre serveur, et vos données ne sortent pas. La contrepartie est réelle : il faut l’entraîner sur vos propres exemples pour qu’il soit fiable.
Le reste de cet article détaille le fonctionnement des deux modèles, leurs chiffres lus avec prudence, et la place qu’ils peuvent prendre dans un système d’information.
Qu’est-ce que Jev AI ?
TypeSafe AI est une société de San Francisco fondée en 2024 par Diogo Almeida, ancien chercheur d’OpenAI qui a participé à la mise au point de ChatGPT, avec Erik Gafni et Sasha Sheng. Après deux ans de travail discret et une levée de 40 millions de dollars (environ 35 millions d’euros) menée par le fonds DCVC, l’entreprise a présenté Jev le 15 septembre 2026. Le modèle est ouvert en accès anticipé, sur liste d’attente.
Son point de départ est un constat que Diogo Almeida résume ainsi auprès de TechCrunch : les LLM sont d’une puissance remarquable, mais ils parlent la langue des humains, alors que les logiciels ont besoin de réponses qu’ils peuvent traiter. Quand une application demande à un LLM de classer un ticket, elle reçoit une phrase qu’il faut ensuite analyser, avec le risque que la réponse sorte des catégories prévues.
Jev prend le problème à l’envers. La réponse est toujours l’une des options que vous avez définies, accompagnée de sa probabilité.
Un nom emprunté à un économiste, un concept à un psychologue
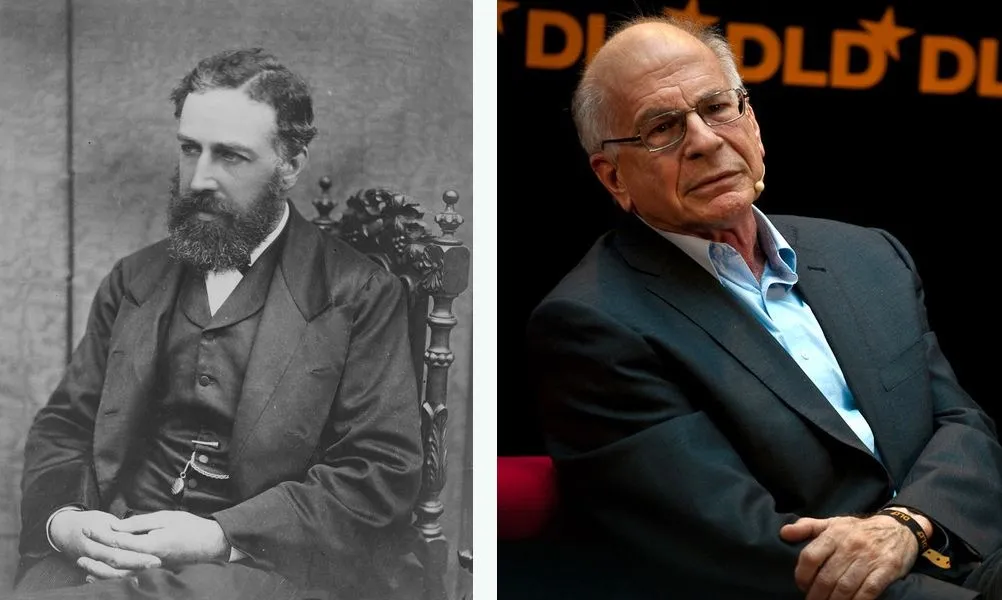
À gauche, William Stanley Jevons (1835-1882), qui a donné son nom à Jev : auteur inconnu, University of Manchester Libraries, CC BY-SA 4.0. À droite, Daniel Kahneman (1934-2024), père de la distinction Système 1 / Système 2 : photo nrkbeta, CC BY-SA 2.0. Montage DPLIANCE sous licence CC BY-SA 4.0.


Le nom rend hommage à William Stanley Jevons, l’économiste qui a observé au XIXᵉ siècle que des machines à vapeur plus économes faisaient augmenter la consommation totale de charbon au lieu de la réduire. Le clin d’œil est assumé : si une décision automatisée ne coûte presque rien, on en prendra beaucoup plus. The Register a d’ailleurs retourné l’argument, en demandant si ce gain d’efficacité réduira vraiment la consommation de calcul.
L’expression « System One » vient du livre Système 1 / Système 2 de Daniel Kahneman. Le psychologue y distingue deux modes de pensée : l’un rapide et intuitif, l’autre lent et délibéré. Les LLM, avec leurs chaînes de raisonnement, jouent le rôle du système 2. Jev revendique le système 1 : le jugement immédiat, celui qui tranche sans rédiger.
Comment fonctionne Jev : décider au lieu d’écrire
Un LLM génère sa réponse un token à la fois. Pour écrire « ce message concerne la facturation », il fait tourner le modèle une fois par morceau de mot, chaque étape dépendant de la précédente. C’est ce qu’on appelle la génération autorégressive, et c’est ce qui prend du temps.
Jev lit la donnée et toutes les questions en une seule passe, en parallèle. Il n’a rien à écrire : il calcule une distribution de probabilités sur les options.
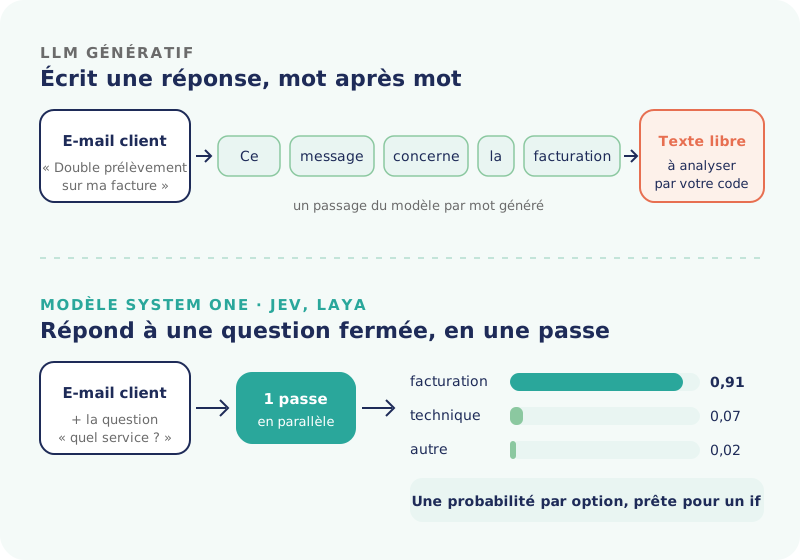
Même e-mail, deux approches. Schéma DPLIANCE.
Trois conséquences pratiques en découlent.
La vitesse. TypeSafe annonce des temps de réponse de 70 à 500 millisecondes, là où un LLM de pointe met souvent plusieurs secondes. Lors d’une démonstration où Jev joue à Doom, il répond en 0,114 seconde contre 8,566 secondes pour GPT-5.6 Terra, d’après The Register.
La sortie toujours conforme. Comme Jev ne peut répondre qu’avec les options fournies, il ne produit jamais de catégorie inventée ni de format cassé. TypeSafe parle d’un modèle « qui ne peut pas halluciner ». La formule mérite une nuance : Jev peut évidemment se tromper d’option. Ce qui disparaît, c’est la réponse hors cadre, pas l’erreur.
Des probabilités qui ont un sens. Jev est entraîné par une méthode que TypeSafe nomme RLCD, pour Reinforcement Learning for Calibrated Decisions. L’objectif est la calibration : quand le modèle annonce 90 % de confiance, il doit avoir raison environ neuf fois sur dix. C’est la propriété la plus utile en production, parce qu’elle permet de fixer un seuil au-delà duquel on automatise sans relecture. Le détail de la méthode n’est pas publié, et TypeSafe indique avoir entraîné Jev uniquement sur des données synthétiques. L’architecture exacte ne l’est pas davantage : d’après TechCrunch, Jev pourrait reposer sur un modèle de langage open source existant, réentraîné pour décider plutôt qu’écrire.
Un modèle de décision, pas un modèle de prévision
Jev renvoie des probabilités, comme un modèle de scoring ou de prévision. Les deux n’ont pourtant pas le même métier.
Un modèle de prévision (risque d’impayé, demande à venir, résultat sportif) apprend sur un historique chiffré de votre activité : il détecte des régularités statistiques pour estimer ce qui va probablement arriver. Jev, lui, ne prévoit pas l’avenir. Il lit une situation décrite en texte et juge quelle option lui correspond le mieux, comme le ferait une personne qui lirait le message.
La fiabilité dépend donc du problème posé. Pour anticiper un impayé à partir de données de paiement, un modèle entraîné sur votre historique fera nettement mieux. Pour comprendre un e-mail ou repérer un dossier incomplet, un modèle chiffré classique ne sait même pas lire le texte : c’est le terrain de Jev.
Comment utiliser Jev : l’API en pratique
Une requête Jev contient deux éléments. Le state est la donnée à juger : un texte, un objet JSON ou une liste. Les questions sont les décisions attendues, chacune d’un type précis.
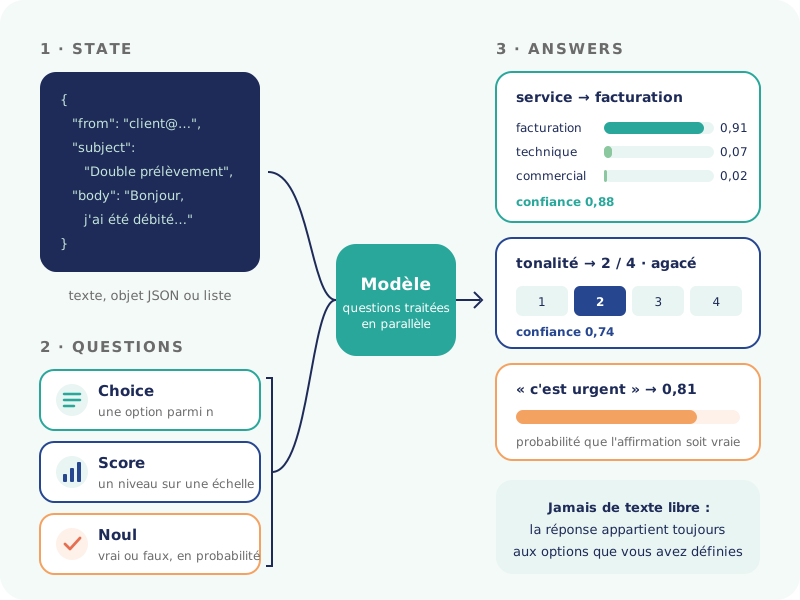
Les trois types de questions et ce que renvoie le modèle. Schéma DPLIANCE d’après la documentation TypeSafe.
- Choice choisit une option parmi une liste que vous définissez, jusqu’à 255 options.
- Score situe la donnée sur une échelle ordonnée : gravité, priorité, qualité.
- Noul donne la probabilité qu’une affirmation soit vraie, par exemple « ce message exprime une urgence ».
Voici l’exemple de la documentation, avec le SDK Python (pip install typesafe-sdk, Python 3.10 ou plus) :
from typesafe_sdk import Choice, Noul, TypeSafeClient

client = TypeSafeClient()  # lit la variable TYPESAFE_API_KEY
r = client.system_one(
    state=ticket,
    questions={
        "department": Choice(
            instructions="Which team should handle this",
            criteria={"billing": "Payment issues", "technical": "Bugs"},
        ),
        "is_urgent": Noul(instructions="The message conveys urgency"),
    },
)

r.answers["department"].choice   # "billing"
r.answers["is_urgent"].noul      # probabilité entre 0 et 1
Chaque réponse de type Choice ou Score renvoie l’option retenue, la probabilité de chaque option et un indice de confiance entre 0 et 1. Un SDK JavaScript existe aussi (@typesafe-ai/sdk), et Jev figure au catalogue de Cloudflare Workers AI.
Les limites à connaître avant d’écrire une ligne
| Paramètre | Valeur documentée |
|---|---|
| Modèle | jev-1.13.0 (alias jev-latest) |
| Contexte | 64 000 tokens par requête, dont 32 000 pour le state et la plus longue question |
| Entrées | Texte uniquement : ni image, ni audio, ni vidéo |
| Langues | Anglais en priorité, autres langues « traitées, mais pas aussi bien » |
| Options par question | 255 au maximum |
| Débit | 250 000 tokens par seconde, 1 200 requêtes par minute, ajustés selon la demande |
| Prix | 0,042 $ (environ 0,037 €) par million de tokens en entrée, sortie gratuite |
| Données | Pas d’entraînement sur vos requêtes ; conservation zéro réservée aux contrats entreprise |
Ce que coûte vraiment une décision
Le tarif se lit mieux avec un exemple. TypeSafe facture en dollars ; les montants ci-dessous sont convertis au cours du 18 septembre 2026 (1 € = 1,148 $). Classer un million d’e-mails de 500 tokens chacun représente 500 millions de tokens en entrée, soit environ 18 euros. Le même volume traité par un LLM généraliste facturé entre 0,17 et 8,70 euros le million de tokens, sortie non comprise, coûte de 90 à 4 400 euros environ.
TypeSafe met en avant un écart moyen de 193 fois plus rapide et 444 fois moins cher que les LLM de référence sur ses propres scénarios. L’entreprise reconnaît elle-même que ces scénarios ont été conçus par son équipe, mesurés depuis la côte ouest américaine, et qu’ils se situent « dans le haut de la fourchette » des gains observés en conditions réelles. Elle admet aussi ne pas pouvoir prouver que ce prix n’est pas subventionné. Des chiffres à vérifier sur vos données, donc, pas à reprendre dans un business plan.
Jev est-il open source ? Non, et c’est là qu’intervient Laya
Jev n’est pas open source. Les poids ne sont pas publiés, l’architecture exacte non plus, et le service tourne sur les serveurs de TypeSafe. Les recherches « Jev GitHub » ou « Jev Hugging Face » mènent à des projets tiers, pas au modèle.
Le 18 septembre 2026, trois jours après l’annonce de TypeSafe, la société Convai Innovations a publié Laya, présenté comme une alternative ouverte. Le code est sur GitHub, les poids sur Hugging Face, le tout sous licence Apache 2.0 : usage commercial autorisé, modification libre.
Laya ne copie pas Jev, dont les poids sont fermés. Il reprend le même contrat d’interface, avec des questions typées en entrée et des probabilités calibrées en sortie, sur une base technique différente : des encodeurs bidirectionnels de la famille BERT, beaucoup plus petits qu’un LLM. Ses auteurs travaillent sur cette approche depuis 2025 et l’ont décrite dans deux articles de recherche (arXiv:2503.23303, arXiv:2510.01237).
Trois modèles, trois usages
| Modèle | Base | Paramètres | Contexte | Usage visé |
|---|---|---|---|---|
laya | ModernBERT-large | 421 M | 512 tokens | Anglais : classification, tri d’e-mails, garde-fous |
laya-multilingual | mmBERT-base | 322 M | 1 024 tokens | Plus de 100 langues, dont le français |
laya-typed-decisions | ModernBERT-large | 421 M | 1 024 tokens | Supervision d’agents, service client, facturation |
L’installation tient en une commande, pip install laya, et l’interface ressemble volontairement à celle de Jev :
from laya import Router

router = Router(preload=True)  # charge les modèles en mémoire au démarrage
state = {"from": "client@exemple.fr", "subject": "Double prélèvement"}
questions = {
    "department": {
        "type": "choice",
        "instructions": "Quel service doit traiter ce message ?",
        "criteria": {
            "facturation": "factures, paiements, remboursements",
            "technique": "bugs, accès, panne",
        },
    }
}
result = router.predict(state, questions)
print(result["answers"]["department"]["choice"])
Laya tourne sur un seul GPU d’entrée de gamme, et même sur CPU pour des volumes modestes. Le paramètre preload=True évite un temps de chargement de 7 à 10 secondes à la première requête.
Jev contre Laya : les benchmarks, lus honnêtement
Convai Innovations publie une comparaison directe avec Jev. Les chiffres sont flatteurs pour Laya ; ils demandent une lecture attentive.
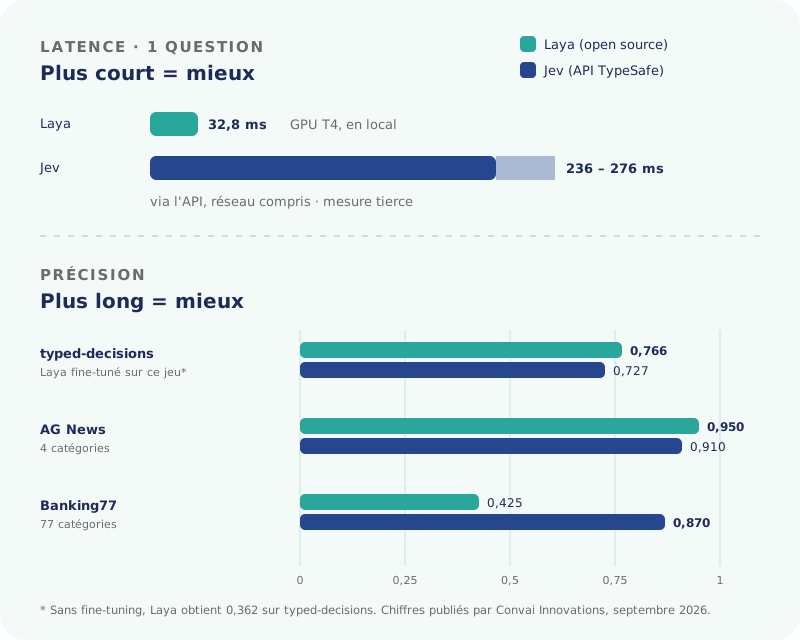
Latence et précision publiées par Convai Innovations. Graphique DPLIANCE d’après la page officielle de Laya et l’analyse de Flowtivity.
La latence compare deux choses différentes. Les 32,8 millisecondes de Laya sont mesurées sur un GPU local. Les 236 à 276 millisecondes de Jev passent par une API distante, trajet réseau compris. L’écart de 7,8 fois est réel pour un utilisateur européen qui appelle un serveur californien, mais il mesure autant la distance que le modèle.
La précision de Laya sur typed-decisions vient d’un modèle entraîné sur ce jeu. Le score de 0,766 appartient à une version fine-tunée sur la partie entraînement du benchmark. Le modèle de base, sans entraînement, obtient 0,362, moins bien qu’une réponse qui choisirait toujours la catégorie la plus fréquente (0,461). Laya est une base à spécialiser, pas un modèle prêt à l’emploi.
Au-delà d’une vingtaine d’options, Jev reprend nettement l’avantage. Sur Banking77, qui compte 77 catégories, Laya tombe à 0,425 quand Jev atteint 0,870. Les auteurs de Laya recommandent eux-mêmes de rester sous 20 options par question.
La calibration de Laya se règle à la main. Son erreur de calibration descend à 0,081 contre 0,246 pour Jev, mais seulement après un ajustement de « température » question par question. Brute, elle est de 0,466 : le modèle se montre trop sûr de lui.
Au bout du compte, chacun a son terrain. Jev fonctionne dès le premier appel et gère les longues listes d’options. Laya est plus rapide chez vous, gratuit à l’usage et entièrement auditable, à condition d’investir dans l’entraînement.
Et en français ?
La question revient souvent, et la réponse est la même pour les deux modèles : ils fonctionnent en français, sans que ce soit leur terrain de référence.
TypeSafe indique que l’anglais est la langue principale de Jev. Les autres langues sont prises en charge, sans garantie de qualité équivalente, et aucun résultat par langue n’est publié.
Côté Laya, le modèle anglais s’effondre dès qu’on sort de l’anglais. Il faut utiliser laya-multilingual, qui obtient des résultats nettement supérieurs au hasard sur 45 des 51 langues testées sur le benchmark MASSIVE. Là encore, aucun score isolé pour le français n’est publié.
La conséquence est pratique : avant de confier un flux en français à l’un ou l’autre, constituez un échantillon de quelques centaines d’exemples réels, étiquetés à la main, et mesurez. C’est une demi-journée de travail qui évite des mois de mauvaises décisions silencieuses.
Où ces modèles trouvent leur place dans une entreprise
Jev et Laya ne remplacent pas un LLM. Ils prennent en charge la partie la plus volumineuse et la plus répétitive du travail, celle où un LLM coûte cher et répond lentement pour une décision simple.
Les cas d’usage les plus solides sont ceux où la question est fermée et le volume élevé :
- Le tri et le routage de messages. Orienter chaque e-mail ou ticket vers le bon service, repérer l’urgence, détecter une demande d’exercice de droits RGPD. Nous détaillons ce chantier dans notre guide du tri des mails par IA.
- Les garde-fous d’un agent IA. Vérifier à chaque étape qu’un agent IA reste dans son périmètre, bloquer une tentative de détournement, décider si une action doit être validée par une personne. À quelques millisecondes par contrôle, on peut en placer partout.
- Le filtrage. Spam, hameçonnage, contenus hors sujet : Laya affiche 0,993 de précision sur le spam et 0,980 sur le hameçonnage dans ses propres tests.
- Le routage entre modèles. Décider si une demande mérite un LLM coûteux ou si un modèle plus léger suffit.
- La pré-qualification. Noter la complétude d’un dossier, la priorité d’une réclamation, la conformité d’une pièce justificative avant l’examen humain.
L’architecture qui fonctionne : la cascade
En production, nous ne recommandons pas de confier toutes les décisions à un modèle de ce type. Nous recommandons de l’utiliser comme premier filtre.
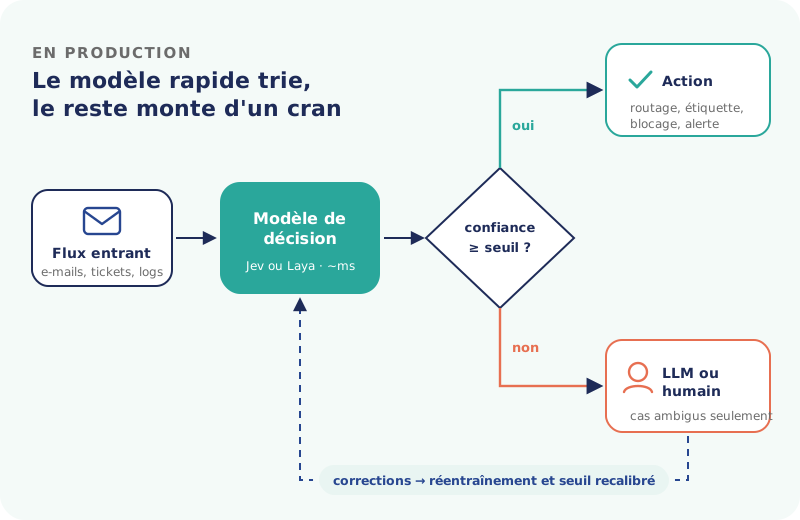
Le modèle rapide traite l’essentiel, les cas ambigus montent d’un cran. Schéma DPLIANCE.
Le principe repose sur la calibration. Au-dessus d’un seuil de confiance fixé à partir de vos données, la décision est appliquée automatiquement. En dessous, la demande part vers un LLM capable de raisonner ou vers une personne. Les corrections faites sur ces cas ambigus reviennent alimenter l’entraînement et affiner le seuil.
Cette architecture concentre la dépense là où elle apporte de la valeur, et elle garde une trace de chaque décision avec sa probabilité, ce qui facilite l’explicabilité exigée par l’IA Act pour certains usages. Elle suppose en revanche un suivi dans la durée : dérive des données, recalibrage régulier, contrôle des erreurs. C’est tout le sujet du MLOps.
Jev ou Laya : comment choisir
La décision dépend moins de la performance brute que de trois questions : où vont vos données, combien de catégories comporte votre problème, et qui maintiendra le système.
| Votre situation | Plutôt Jev | Plutôt Laya |
|---|---|---|
| Vous voulez un premier résultat cette semaine | ✅ Fonctionne sans entraînement | ⚠️ Fine-tuning indispensable |
| Plus de 20 options par question | ✅ 0,870 de précision sur 77 catégories | ⚠️ Précision en forte baisse |
| Données personnelles, santé, secret professionnel | ⚠️ Transfert vers les États-Unis à encadrer | ✅ Rien ne sort de votre serveur |
| Volumes très élevés et stables | 🟡 Très bon marché, mais facturé à l’usage | ✅ Coût fixe du serveur, quel que soit le volume |
| Pas d’équipe data en interne | ✅ Service géré | ⚠️ Entraînement, calibration et hébergement à assurer |
| Besoin d’auditer ou de figer le modèle | ⚠️ Modèle fermé, versions gérées par TypeSafe | ✅ Poids ouverts, version figée, audit complet |
| Textes en français | 🟡 Pris en charge, à tester | 🟡 Modèle multilingue, à tester et à entraîner |
Deux critères méritent une attention particulière pour une organisation européenne.
Le cadre juridique. Jev est hébergé aux États-Unis. TypeSafe propose un accord de traitement des données et s’engage à ne pas entraîner son modèle sur vos requêtes, mais tout envoi de données personnelles reste un transfert hors de l’Union européenne, avec les obligations que cela implique au titre du RGPD. Nous en détaillons les ressorts dans notre guide de l’IA conforme au RGPD. Laya, hébergé chez vous ou chez un hébergeur européen, supprime la question.
La maîtrise du modèle dans le temps. Avec une API, le fournisseur peut changer le modèle, son prix ou ses conditions. Jev a d’ailleurs brièvement saturé sous la demande le jour de son lancement. Avec des poids ouverts, vous figez une version, vous la testez, et elle ne bouge plus tant que vous ne le décidez pas. C’est la logique que nous développons dans notre article sur les LLM en local.
Dans la pratique, les deux ne s’excluent pas. Prototyper sur Jev pour valider la taxonomie et mesurer le gain, puis basculer sur Laya fine-tuné une fois le besoin stabilisé, est souvent le chemin le plus court vers un système que vous maîtrisez.
Ce que nous refusons de promettre
« Jev ne se trompe jamais. » Il ne sort jamais du cadre fixé, ce qui est différent. Il peut choisir la mauvaise option, et il le fera sur une partie de vos données. Ce qui compte est de mesurer cette part et de décider quoi faire des cas incertains.
« 444 fois moins cher, donc rentable partout. » Ce chiffre vient des scénarios de TypeSafe, sur des tâches choisies pour mettre le modèle en valeur. Sur votre flux, le gain peut être plus faible. Et le coût d’un projet se joue surtout ailleurs : définir les catégories, étiqueter des exemples, brancher le modèle sur vos outils, surveiller sa précision.
« Laya, c’est Jev en gratuit. » Laya est gratuit à l’usage, pas à la mise en place. Sans fine-tuning, il fait moins bien, sur son propre benchmark, qu’une règle naïve qui répondrait toujours la catégorie la plus fréquente. Le temps d’entraînement et d’exploitation fait partie du prix.
« Il faut tout migrer vers ces modèles. » Non. Ils excellent sur les questions fermées. Dès qu’il faut rédiger, résumer, extraire une information libre ou raisonner en plusieurs étapes, un LLM reste le bon outil. L’intérêt est de les combiner.
Ces deux modèles ont moins d’une semaine. Leurs chiffres seront confirmés ou corrigés par des tests indépendants dans les mois qui viennent, et nous mettrons cet article à jour en conséquence.
DPLIANCE est une agence IA : nous aidons les entreprises à choisir, intégrer et exploiter ce type de modèle dans leurs processus. Si vous vous demandez si un modèle de décision peut prendre en charge une partie de vos flux, un échange de cadrage permet de le vérifier sur vos propres données.
FAQ
Qu’est-ce que Jev AI ?
Jev est un modèle d’intelligence artificielle de la start-up américaine TypeSafe AI, fondée en 2024 par Diogo Almeida, ancien chercheur d’OpenAI. Lancé le 15 septembre 2026, il appartient à une catégorie que TypeSafe appelle les modèles System One : au lieu de générer du texte, il répond à des questions fermées en renvoyant une probabilité pour chaque option possible. Il sert à trier, classer, noter ou vérifier des données à très grande vitesse, à l’intérieur d’un logiciel.
Jev est-il un LLM ?
Pas au sens habituel. TypeSafe ne publie pas son architecture, mais Jev repose probablement sur un modèle de langage, réentraîné pour une autre tâche : au lieu de générer du texte, il choisit parmi des options fixées et renvoie une probabilité calibrée pour chacune. Il lit la donnée et les questions en une seule passe, ce qui le rend beaucoup plus rapide et moins cher qu’un LLM. C’est aussi sa limite : il ne sait ni rédiger, ni résumer, ni converser.
Combien coûte Jev ?
TypeSafe facture 0,042 dollar par million de tokens en entrée, soit environ 3,7 centimes d’euro, ou 37 euros par milliard. Les tokens de sortie sont gratuits. À titre d’ordre de grandeur, classer un million d’e-mails de 500 tokens chacun représente 500 millions de tokens, soit environ 18 euros. Le modèle est en accès anticipé : il faut s’inscrire sur une liste d’attente pour obtenir une clé d’API.
Jev est-il open source ?
Non. Ni les poids ni l’architecture détaillée de Jev ne sont publiés : on y accède uniquement par l’API de TypeSafe, dont les serveurs sont situés sur la côte ouest des États-Unis. Il n’existe pas de dépôt officiel de Jev sur GitHub ou Hugging Face. L’alternative ouverte la plus avancée est Laya, publiée par Convai Innovations sous licence Apache 2.0.
Qu’est-ce que Laya ?
Laya est une famille de modèles de décision publiée le 18 septembre 2026 par Convai Innovations, sous licence Apache 2.0. Elle reprend le principe de Jev (des questions typées, des probabilités en sortie) avec des encodeurs de 322 à 421 millions de paramètres, installables via pip et exécutables sur un seul GPU. Sa principale limite : sans fine-tuning sur vos propres données, ses résultats restent proches du hasard.
Jev fonctionne-t-il en français ?
Oui, mais ce n’est pas sa langue de référence. La documentation de TypeSafe indique que l’anglais est la langue principale et que les autres langues sont traitées, mais pas aussi bien. Côté Laya, il faut utiliser le modèle laya-multilingual, qui couvre plus de 100 langues ; le modèle anglais s’effondre hors de l’anglais. Dans les deux cas, un test sur un échantillon de vos propres données en français est indispensable avant toute mise en production.
Faut-il choisir Jev ou Laya ?
Jev convient pour démarrer vite, sans équipe de machine learning, et pour les questions à nombreuses options : il reste précis jusqu’à 77 catégories là où Laya décroche. Laya convient quand les données ne doivent pas quitter votre infrastructure, quand les volumes sont élevés et stables, et quand vous pouvez consacrer quelques jours à l’étiquetage et au fine-tuning. Beaucoup de projets gagnent à prototyper sur Jev, puis à basculer sur Laya une fois le besoin stabilisé.
Sources
- TypeSafe AI, Introducing System One Models & Jev, 15 septembre 2026
- TypeSafe AI, documentation des modèles
- TechCrunch, A new kind of AI model from a ChatGPT inventor is thrilling developers, 18 septembre 2026
- The Register, TypeSafe AI debuts model for machines that plays Doom, 16 septembre 2026
- MarkTechPost, TypeSafe AI Releases Jev, 19 septembre 2026
- Convai Innovations, site officiel de Laya, dépôt GitHub et modèles sur Hugging Face
- Flowtivity, Laya: The Open-Source Jev Alternative, Benchmarked Honestly